
Muse Spark 1.3 entra al grupo frontera
Una lectura de los benchmarks de Artificial Analysis: la variante max de Muse supera por un punto a GPT-5.6 Sol en vista previa.
This publication is currently available in Spanish. Read the original ↗
Pregunta
¿Muse Spark 1.3 es realmente una entrada de Meta al grupo de modelos frontera, o solo una mejora incremental frente a Spark 1.2?
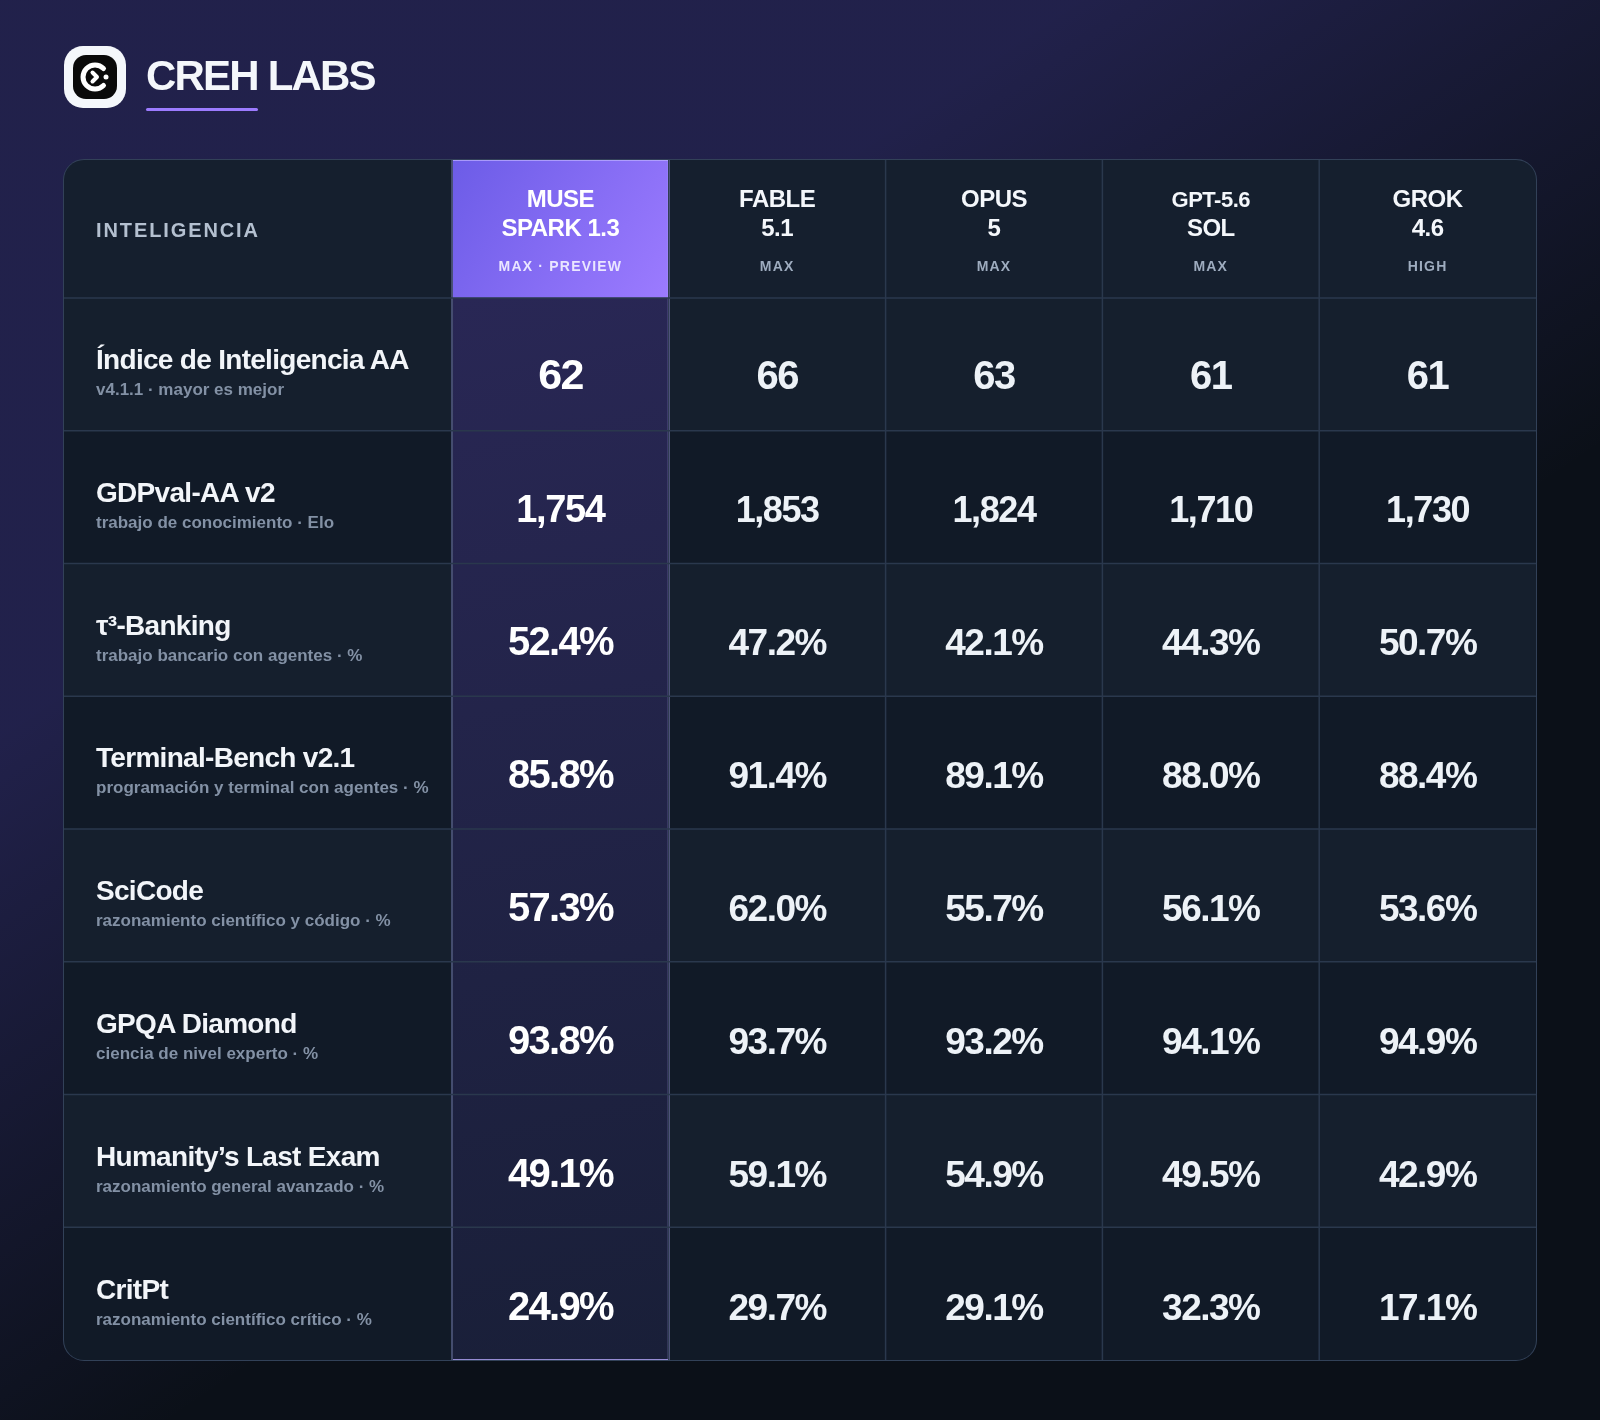
La respuesta corta es que ya entra en esa conversación. Artificial Analysis sitúa a Muse Spark 1.3 max en 62 puntos de su índice de inteligencia, un punto por encima de GPT-5.6 Sol max (61). Esa configuración de Muse sigue en vista previa limitada; la versión pública xhigh obtiene 61 y empata con GPT-5.6 Sol max y Grok 4.6 high.
Evidencia
La tabla reúne las configuraciones de mayor capacidad medidas por Artificial Analysis:
- Fable 5.1
maxconserva el primer lugar con 66 puntos. - Opus 5
maxle sigue con 63. - Muse Spark 1.3
maxalcanza 62 en vista previa. - GPT-5.6 Sol
maxy Grok 4.6highquedan en 61.
El índice AA v4.1.1 combina nueve evaluaciones: trabajo de conocimiento, uso de herramientas, programación agéntica, ciencia y razonamiento general. En los datos desagregados, Muse destaca especialmente en trabajo bancario con agentes: su configuración max logra 52.4% en τ³-Banking. Fable continúa por delante en el total gracias a sus resultados en trabajo de conocimiento, Terminal-Bench, SciCode y Humanity’s Last Exam.
La ficha técnica de Meta centra su comparación en Muse Spark 1.3, Spark 1.2, Opus 5 y GPT-5.6 Sol. Meta reporta mejoras en tareas de código respecto de Spark 1.2, incluidas menos llamadas a herramientas y menor uso de tokens; esas cifras son del propio proveedor, mientras que la tabla usa la medición independiente de Artificial Analysis.
Interpretación y límites
El resultado relevante no es que Meta haya tomado el primer puesto absoluto: Fable 5.1 y Opus 5 aún lo mantienen. Lo relevante es que Muse Spark 1.3 ya cruza el umbral de los 61–62 puntos y lo hace con una versión pública que compite directamente con la configuración más capaz de GPT-5.6 Sol en el índice agregado.
No conviene presentar max como una oferta comercial disponible para todos. Meta no ha publicado precio para esa variante de vista previa; por eso la comparativa de coste y velocidad usa Muse Spark 1.3 xhigh. Un benchmark tampoco sustituye una prueba en el flujo de trabajo real: los resultados cambian según la herramienta, el contexto, el presupuesto de razonamiento y la calidad del agente.