
Opus 5 frente a Fable 5.1: la nueva frontera de Anthropic
Fable 5.1 supera a Opus 5 en los benchmarks comparables del lanzamiento y redefine la referencia de Anthropic para agentes de largo recorrido.
This publication is currently available in Spanish. Read the original ↗
Pregunta
¿Qué cambia cuando Fable 5.1 se compara directamente con Opus 5, GPT-5.6 Sol y su predecesor Fable 5 en los benchmarks del lanzamiento?
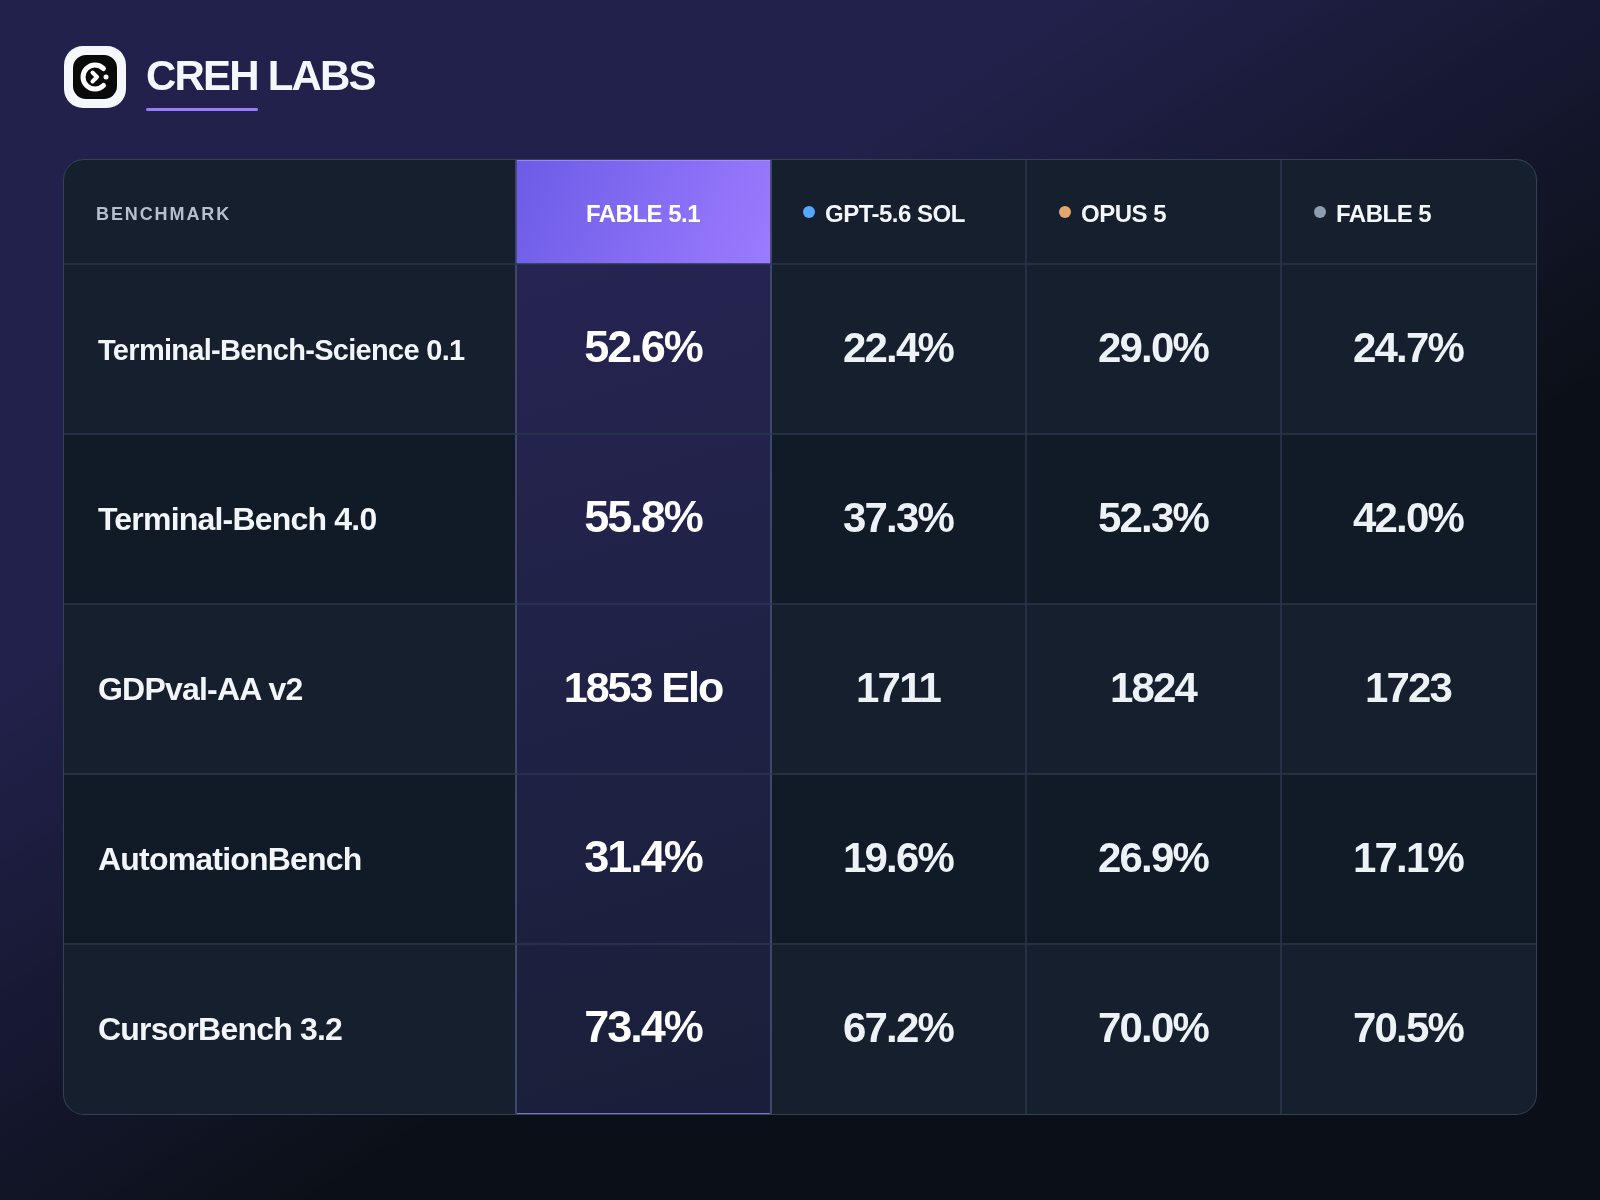
La respuesta no es que Fable 5.1 gane todas las filas. La señal es más concreta: Anthropic lo sitúa por delante de Opus 5 en los cinco benchmarks de su tabla que tienen resultados comparables para los cuatro modelos, con ventajas especialmente claras en investigación científica agéntica y trabajo de conocimiento.
Evidencia
La tabla utiliza exactamente la cohorte y las cifras del anuncio de Anthropic. Fable 5 es una referencia de la generación anterior; los modelos frontera de la comparación son Fable 5.1, Opus 5 y GPT-5.6 Sol.
| Benchmark | Fable 5.1 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 29.0% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 52.3% | 37.3% |
| GDPval-AA v2 | 1853 Elo | 1824 Elo | 1711 Elo |
| AutomationBench | 31.4% | 26.9% | 19.6% |
| CursorBench 3.2.0 | 73.4% | 70.0% | 67.2% |
La diferencia más visible está en Terminal-Bench-Science: Fable 5.1 marca 52.6%, frente a 29.0% de Opus 5. En tareas de conocimiento, su resultado de 1853 Elo en GDPval-AA v2 supera los 1824 de Opus 5. También mantiene una ventaja más estrecha en programación agéntica, automatización y CursorBench.
Anthropic informa que Fable 5.1 se evaluó con sus salvaguardas de producción activadas. En determinadas tareas, dichas salvaguardas pueden intervenir o derivar trabajo a otros modelos; ese detalle importa al interpretar el resultado como un sistema de producción, no como una puntuación aislada de pesos sin restricciones.
Interpretación y límites
Fable 5.1 parece ser la evolución de Anthropic para trabajos largos y agénticos que antes se asociaban a Opus 5. La tabla no demuestra que sea la mejor elección para cada tarea, pero sí muestra una mejora sostenida sobre Opus 5 dentro de la misma comparación de lanzamiento.
Estos resultados proceden de Anthropic y no de un rerun independiente común hecho por CREH LABS. Los benchmarks, los niveles de esfuerzo, los harnesses, los costes y las salvaguardas condicionan la comparación. Por eso esta lectura debe complementarse con pruebas sobre el caso de uso real, sobre todo si el flujo depende de herramientas, contexto largo o ejecución autónoma.