
SAGE-CREH: coordinación adaptativa de subagentes y skills
Actualizado 13 set. 2026
Preprint: manuscrito sin revisión por pares acreditada.
Resumen
Una quinta arquitectura, las mismas doce tareas y 216 ejecuciones nuevas: comparación de cumplimiento, tokens, tiempo y reparto de skills, con código y datos.
¿Cómo conviene organizar los subagentes?
Código y datos reproducibles: repositorio SAGE-CREH en GitHub.
El objetivo de esta investigación es comparar arquitecturas de coordinación y reparto de skills, no modelos distintos. ¿Quién resuelve? ¿Quién comprueba? ¿Cuándo aporta valor delegar? ¿Qué instrucciones necesita realmente cada trabajador?
La versión anterior estudió cuatro patrones: secuencial, paralelo, jerárquico y reflexivo. Esta actualización añade una quinta arquitectura implementada en CREH Labs, SAGE-CREH, y vuelve a ejecutar los controles originales con las mismas tareas y el mismo modelo. El artículo amplía su revisión de nueve a doce papers de arXiv.
SAGE-CREH logró 23/24 aciertos estrictos (95,8%), con 1.765 tokens y 7,34 segundos medios por tarea. Consumió un 47,2% menos tokens que la secuencial, un 49,3% menos que la paralela, un 61,1% menos que la jerárquica y un 30,2% menos que la reflexiva.
Fue el mayor puntaje estricto observado, pero no ganó con todos los criterios. Al normalizar únicamente el envoltorio SQL, secuencial y reflexiva alcanzaron 24/24; SAGE y el agente único original, 23/24. El agente único necesitó menos recursos: 1.160 tokens y 4,62 segundos medios. La diferencia de latencia entre SAGE y la paralela fue pequeña e incierta.
El control SAGE sin delegación obtuvo 21/24 con 1.110 tokens: coordinar agregó un 59,1% de tokens y dos aciertos en esta muestra. Dos fallos de ese control eran sobres JSON con una clave extra, no eliminada por la normalización SQL predefinida. En las propias trazas de SAGE, cinco primeros candidatos se corrigieron: tres por contrato SQL y dos mediante arbitraje en dependencias y selección. Su único fallo final fue contar siete eventos en vez de ocho en T02, aunque las sumas monetarias eran correctas.
La lectura práctica es condicional: SAGE ofrece un buen compromiso para exigir respuestas estrictas con menos gasto que los equipos fijos. Si se permite normalizar SQL y prima el coste, esta muestra favorece al agente único; si prima el cumplimiento normalizado observado, la reflexiva resulta más económica y rápida que la secuencial. Los intervalos de diferencias de acierto no permiten proclamar superioridad general.
La quinta arquitectura: SAGE-CREH
SAGE-CREH combina selección de skills y delegación condicional. Un coordinador determinista reconoce la estructura pública de la tarea, carga las instrucciones pertinentes y elige entre dos caminos:
- Vía directa: un resolutor propone una respuesta. Si cumple el contrato de salida y no declara dudas concretas, termina. Si no, un verificador revisa la propuesta.
- Vía con subagentes: ante complejidad estructural previamente definida, dos resolutores independientes trabajan simultáneamente. Uno se centra en la solución completa y el otro presta especial atención a restricciones, dependencias y desempates. Si entregan el mismo candidato válido y sin dudas, se evita el integrador; si discrepan, interviene un árbitro.
La política activa dos resolutores en grafos de al menos ocho nodos con algún nodo de dos o más predecesores, y en selección de al menos diez elementos con incompatibilidades y prerrequisitos. Estas reglas se fijaron antes de la réplica. La compuerta valida formato, no sabe la respuesta correcta. Coincidir tampoco garantiza que dos agentes tengan razón.
El árbitro recibe los datos originales y las propuestas, nunca el resultado del evaluador. No hay acceso a respuestas de referencia, ejecución de SQL contra las bases ocultas ni reintentos hasta acertar. El nombre identifica esta composición local; no reivindica haber inventado el enrutamiento adaptativo.
Las cinco arquitecturas, lado a lado
| Arquitectura | Organización implementada | Llamadas por tarea |
|---|---|---|
| Secuencial | Extracción, resolución e integración, una etapa después de otra. | 3 |
| Paralela | Dos especialistas complementarios simultáneos y un integrador fijo. | 3 |
| Jerárquica | Supervisor planifica uno o dos encargos, trabajadores ejecutan y se integra. | 3–4 |
| Reflexiva | Propuesta, crítica y revisión cuando hay objeciones; máximo dos rondas. | 2–5 |
| SAGE-CREH | Vía directa o dos resolutores independientes; arbitraje solo cuando corresponde. | 1–3 |
También se mantiene un agente único de una llamada. Todos usan el mismo modelo; cambiar de rol no equivale a cambiar sus pesos. La vía paralela de SAGE introduce redundancia selectiva, mientras el paralelo original divide responsabilidades complementarias de manera fija.
Cómo se reparten los skills
El catálogo conserva diez skills: seis pertinentes para los problemas y cuatro distractores. SAGE identifica la interfaz por los campos públicos de la tarea y entrega solo el cuerpo de instrucciones pertinente. No envía el catálogo completo de descripciones en cada llamada.
| Familia de tarea | Responsabilidad del skill |
|---|---|
| Registros | Revisiones, estados y sumas monetarias. |
| Calendario | Zonas horarias y disponibilidad común. |
| Dependencias | Precedencias, inicios tempranos y camino crítico. |
| Selección | Presupuesto, cobertura, incompatibilidades y desempates. |
| Memoria | Confirmaciones, borrados, ámbitos y herencia. |
| SQL | Consultas de solo lectura, agregaciones y condiciones de borde. |
Los agentes de una misma tarea pueden recibir el mismo skill con roles diferentes. Todos conservan los datos públicos completos. Aquí se evalúa un adaptador cerrado de interfaces, no un buscador semántico de skills para conversaciones abiertas.
Benchmark: misma tarea, mismo modelo y evaluador
La nueva tanda contiene 216 ejecuciones, 510 llamadas y 707,090 tokens observados. Se registraron 0 errores de infraestructura o protocolo. Los costes de desarrollo se muestran aparte.
Las doce tareas originales se repiten dos veces en nueve condiciones: cuatro arquitecturas, agente único, SAGE y tres controles de ablación. Hay 24 ejecuciones por condición. Diez problemas se califican por coincidencia exacta; cada una de las dos consultas SQL se prueba en tres bases ocultas para los agentes.
Se utiliza GPT-5.6 Luna con esfuerzo bajo y máximo 1.536 tokens de salida por llamada, incluido razonamiento. Los controles mantienen sus prompts originales. Se aleatoriza el orden por tarea y repetición, con una condición a la vez y un máximo de dos llamadas simultáneas dentro del flujo. Se conserva el identificador y la configuración del modelo.
Resultados de la réplica
| Configuración | Estricto | SQL norm. | Tokens | s/tarea | Llamadas |
|---|---|---|---|---|---|
| Agente único | 19/24 | 23/24 | 1,160 | 4.62 | 24 |
| Secuencial | 20/24 | 24/24 | 3,343 | 12.47 | 72 |
| Paralela | 19/24 | 22/24 | 3,480 | 7.69 | 72 |
| Jerárquica | 18/24 | 22/24 | 4,532 | 11.13 | 96 |
| Reflexiva | 20/24 | 24/24 | 2,527 | 9.54 | 54 |
| SAGE-CREH | 23/24 | 23/24 | 1,765 | 7.34 | 38 |
Tokens y segundos son medias por tarea; llamadas es el total por condición. El tiempo incluye red y coordinación, excluyendo el evaluador. Los tokens suman todas las entradas y salidas: caché y razonamiento ya están incluidos, no se suman dos veces.
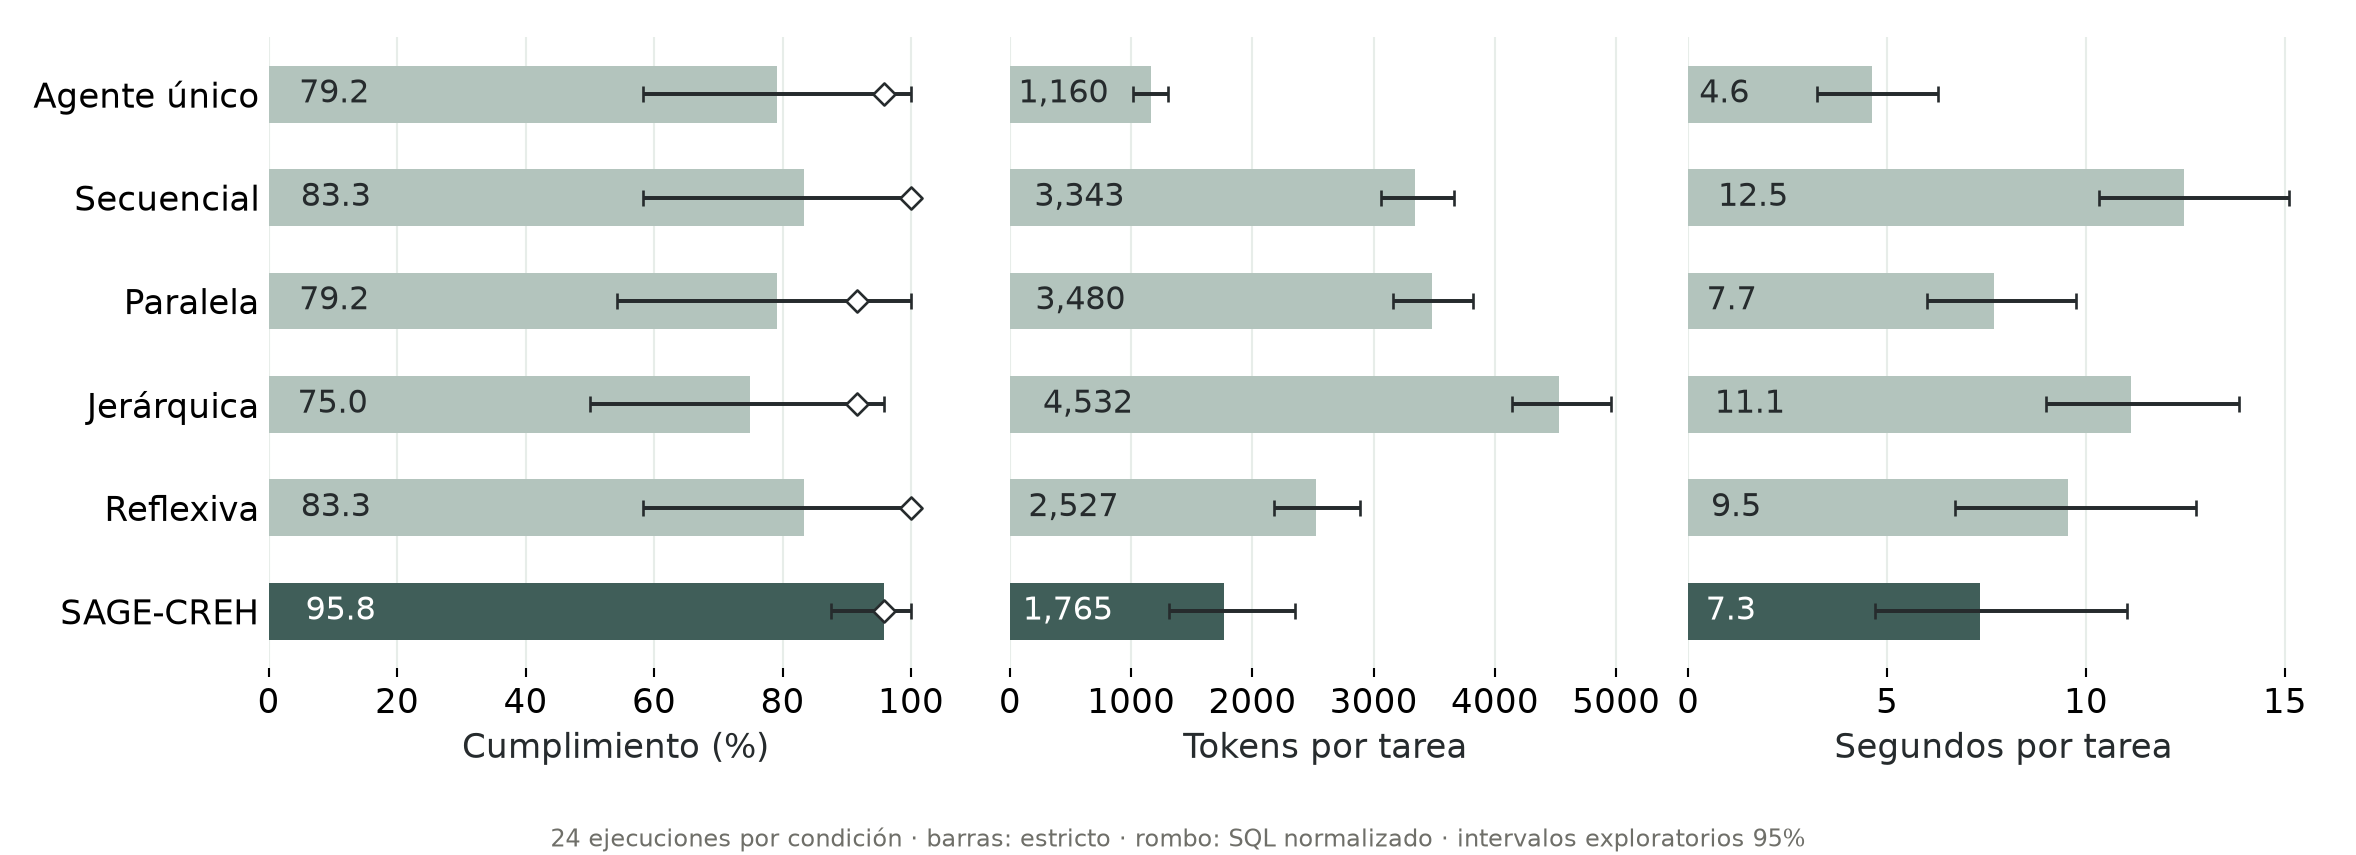
La columna estricta exige el sobre JSON original. La secundaria SQL norm. únicamente envuelve una cadena SQL en el campo anidado solicitado y aplica el mismo evaluador: no cambia consultas ni corrige soluciones. Esta sensibilidad se detectó en v1 y se predefinió como métrica secundaria para v2. No debe confundirse una mejora de formato con mejor razonamiento.
Los intervalos del paper usan 10.000 remuestreos emparejados por tarea, conservando ambas repeticiones. Son doce tareas distintas, no 216 problemas independientes. Los intervalos son exploratorios y los efectos techo no demuestran fiabilidad perfecta.
¿La diferencia viene de coordinar o de cargar instrucciones?
| Configuración | Estricto | SQL norm. | Tokens | s/tarea | Llamadas |
|---|---|---|---|---|---|
| Jerárquica | 18/24 | 22/24 | 4,532 | 11.13 | 96 |
| Jerárquica + 10 skills | 20/24 | 22/24 | 8,578 | 10.62 | 96 |
| SAGE-CREH | 23/24 | 23/24 | 1,765 | 7.34 | 38 |
| SAGE sin delegación | 21/24 | 21/24 | 1,110 | 5.93 | 24 |
| SAGE + 10 skills | 22/24 | 22/24 | 2,966 | 6.38 | 34 |
SAGE sin delegación usa el mismo proponente y carga de instrucciones, pero nunca llama a otro agente. SAGE con diez skills mantiene la política, pero entrega todos los cuerpos de instrucciones. La pareja jerárquica original mide también el coste de esa carga.
Frente a los patrones originales, SAGE cambia topología, prompts y exposición al catálogo. Estas ablaciones ayudan a distinguir efectos; no sería correcto atribuir toda la diferencia exclusivamente a la coordinación.
Rutas observadas en SAGE: 13 vía directa, 5 acuerdo paralelo sin integrador, 3 arbitraje tras dos propuestas, 3 revisión selectiva.
Desarrollo y elección de la política
Se probaron dos políticas en diez instancias nuevas, sin mezclar sus datos con la réplica: serial, 9/10, 1,606.7 tokens y 9.07 segundos medios; paralela, 10/10, 1,628.4 tokens y 8.11 segundos medios. Se eligió la paralela por mayor cumplimiento, según la regla fijada previamente. Desarrollo sumó 20 ejecuciones, 28 llamadas y 32,351 tokens.
Se conservaron todos los intentos. La selección quedó registrada antes de la réplica y la arquitectura se congeló durante las 216 ejecuciones. Los tests offline verifican contratos, rutas y contabilidad: sus resultados no se cuentan como aciertos del modelo.
El acierto que separó a los candidatos ocurrió en DEV22, una tarea de calendario donde ambos usaron la misma vía directa, sin revisión. Esa variación no demuestra un efecto causal del paralelismo; la elección se conserva conforme a la regla previa.
Qué aportó la bibliografía al diseño
La carga progresiva de instrucciones y la separación entre skills y trabajadores fundamentan el control del contexto. La ampliación incorpora delegación selectiva de Uno-Orchestra, decisiones condicionadas al progreso de ProgRouter y revisión de continuaciones de TROVE. Son fundamentos conceptuales: no se reproduce su entrenamiento ni se usan sus puntuaciones como resultados propios.
Alcance y materiales
Es un preprint exploratorio sin revisión por pares. Las tareas finales ya eran conocidas durante el diseño: esta es una réplica emparejada informada por desarrollo, no una prueba a ciegas de generalización. Se evalúan un modelo, contextos cortos y tareas sintéticas, sin terminal, navegación, programación de varios archivos, memoria persistente ni RAM.
La elección práctica debe atender simultáneamente a cumplimiento, tokens y espera. Las trazas permiten comprobar cuándo una revisión corrigió algo y cuándo solo añadió coste. Las dos tandas se conservan separadas; la latencia antigua no se mezcla con la nueva.
- Paper v2 completo en español.
- Full v2 paper in English.
- Código, fuentes LaTeX, protocolos y todas las trazas.
- Hoja de cálculo con las nueve condiciones.
- Resumen CSV, ejecuciones CSV y comparaciones emparejadas.
- Rutas y correcciones, sensibilidad SQL y hashes.
- Versión histórica v1 en español y datos v1 preservados.
El paquete contiene únicamente datos sintéticos, respuestas visibles y materiales de investigación. No incluye credenciales, conversaciones privadas ni razonamiento privado.
Fuentes y versiones consultadas
- Agent Skills for Large Language Models: Architecture, Acquisition, Security, and the Path Forward — 2602.12430v4; 2026-02-12.
- Benchmarking Multi-Agent LLM Architectures for Financial Document Processing: A Comparative Study of Orchestration Patterns, Cost-Accuracy Tradeoffs and Production Scaling Strategies — 2603.22651v1; 2026-03-24.
- CRAFT: Grounded Multi-Agent Coordination Under Partial Information — 2603.25268v2; 2026-03-26.
- EvoAgent: An Evolvable Agent Framework with Skill Learning and Multi-Agent Delegation — 2604.20133v3; 2026-04-22.
- Swarm Skills: A Portable, Self-Evolving Multi-Agent System Specification for Coordination Engineering — 2605.10052v2; 2026-05-11.
- When Does Hierarchy Help? Benchmarking Agent Coordination in Event-Driven Industrial Scheduling — 2605.13172v1; 2026-05-13.
- Beyond Sequential Interaction: Benchmarking Parallel Execution and Coordination for GUI Agents — 2607.22689v1; 2026-07-17.
- OrchBench: Evaluating Multi-Agent Orchestration Plans in Isolation via Deterministic Simulation — 2607.25656v1; 2026-07-28.
- Subagents vs Agent Skills: Executing Reusable Knowledge for Long-Horizon Agentic Tasks — 2609.09233v1; 2026-09-07.
- GPT-5.6 Luna Model — Documentation accessed 2026-09-13; Accessed 2026-09-13.
- Uno-Orchestra: Parsimonious Agent Routing via Selective Delegation — 2605.05007v1; 2026-05-06.
- ProgRouter: Online Progress-Guided Orchestration for Multi-Agent LLM Workflows under Quality-Cost Tradeoffs — 2608.25992v1; 2026-08-26.
- TROVE: Adaptive Agent Skill Orchestration via Trace-Grounded Route Validation and Editing — 2609.05019v1; 2026-09-04.